O que você precisa saber
Transformer é uma arquitetura de rede neural apresentada em 2017 que usa mecanismos de atenção para relacionar representações de uma sequência. Ela combina atenção, transformações por posição, conexões residuais e outros componentes. Tem antecedentes em décadas de machine learning e não é, por si só, uma conexão automática à internet ou uma garantia de compreensão factual.
A história começa antes do chat
Em 1959, Arthur Samuel publicou trabalho sobre aprendizagem em jogos de damas, um marco associado à história de machine learning. Em 2003, Bengio e colaboradores apresentaram um modelo neural probabilístico de linguagem com representações distribuídas. Esses marcos não significam que toda a pesquisa em IA começou nessas datas; situam mudanças importantes dentro de uma história mais longa.
Em 2013, trabalhos sobre Word2Vec ampliaram o interesse por representações vetoriais de palavras. Em 2017, Attention Is All You Need apresentou o Transformer. Em 2020, o artigo de Lewis e colaboradores formalizou uma abordagem RAG que combina modelo paramétrico e memória externa recuperável. Em 2024, a pesquisa da Microsoft sobre GraphRAG descreveu uma abordagem de síntese com grafos e comunidades. Busca, memória externa, grafos e atenção têm antecedentes; os artigos são marcos, não o nascimento de todas essas ideias.
O que o Transformer recebe
A entrada passa por representação numérica. No processamento de texto, o tokenizador produz IDs e o modelo os associa a embeddings. Como a atenção isolada não determina a ordem da sequência, a arquitetura precisa incorporar informação posicional. Diferentes modelos fazem isso com métodos diferentes. A partir dessa entrada, as camadas produzem representações contextualizadas.
Na frase hipotética 'a escola ligou para a família porque ela pediu uma visita', interpretar 'ela' depende de relações entre partes da frase. O mecanismo de atenção ajuda a calcular relações úteis entre posições. Isso não implica que cada cabeça de atenção tenha um significado humano transparente ou que o modelo resolva toda ambiguidade corretamente.
Encoder, decoder e combinações
O Transformer original usa encoder e decoder para transdução de sequências. Modelos posteriores podem usar apenas encoder, apenas decoder ou ambos. Encoders são comuns em representação e classificação; decoders autoregressivos são comuns na geração. A arquitetura escolhida e o objetivo de treinamento moldam o comportamento.
Para continuar este critério: Tokens de IA: o que são e para onde vão quando usados →
Atenção: consultas, chaves e valores
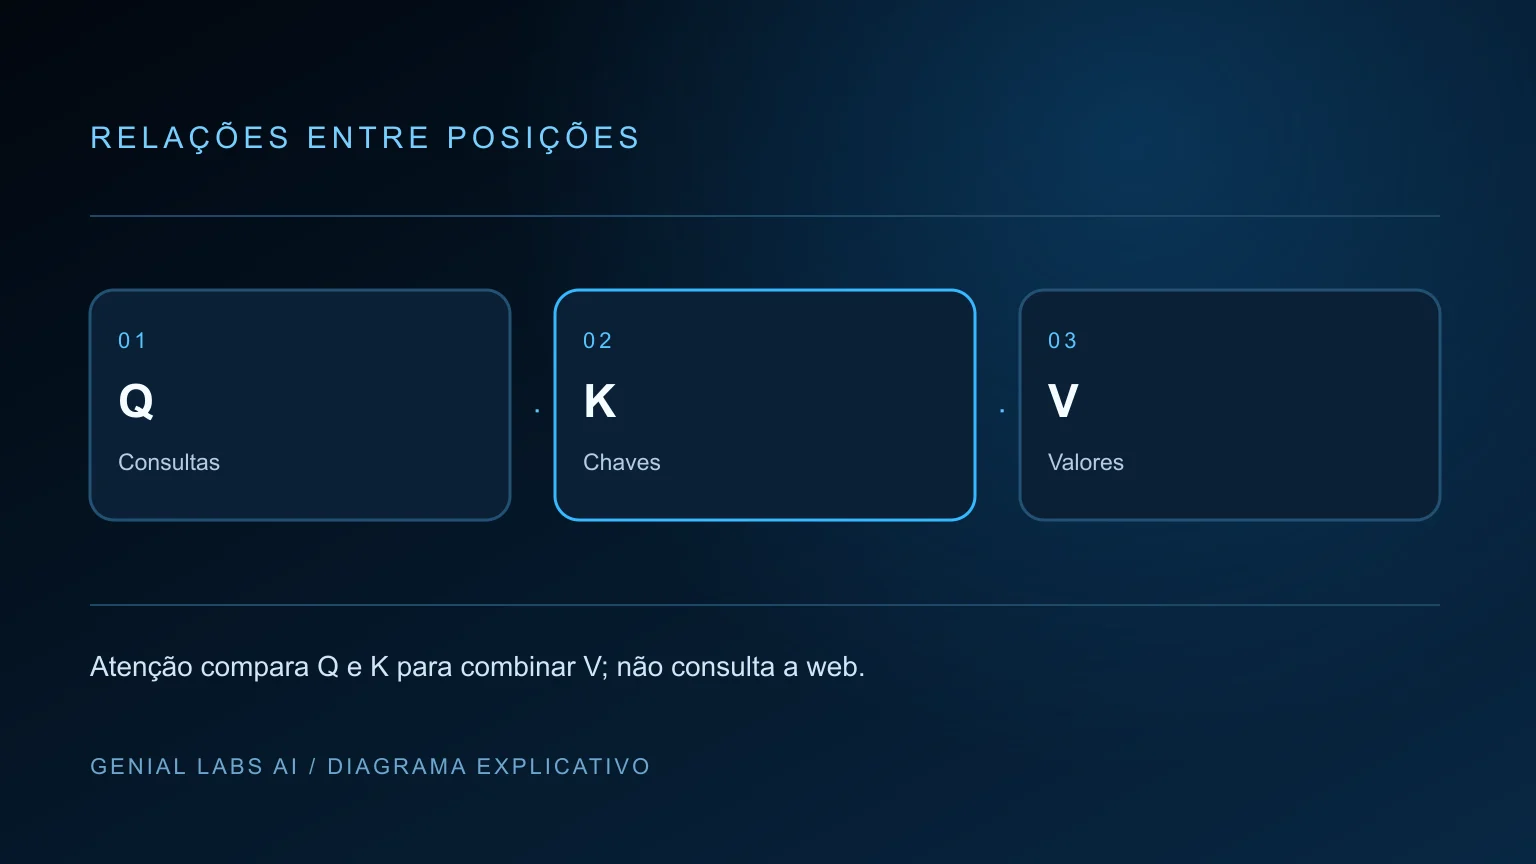
As representações são projetadas em matrizes chamadas queries (Q), keys (K) e values (V). Uma consulta é comparada às chaves; os escores são escalados e transformados em pesos por softmax. Esses pesos combinam os valores. Na atenção por produto escalar escalado, a expressão é Attention(Q,K,V) = softmax(QKᵀ/√dₖ)V. O fator de escala ajuda a controlar a magnitude dos escores.
Multi-head attention calcula várias dessas relações em paralelo com projeções aprendidas, e combina seus resultados. Num decoder causal, uma máscara impede que uma posição use tokens futuros no processo autoregressivo. Portanto, 'atenção olha todo o texto' exige qualificação: o conjunto de posições acessíveis depende da arquitetura, da máscara e da implementação.
Atenção não é uma busca na internet
Q/K/V são operações sobre representações disponíveis no cálculo. Elas não abrem páginas da web por conta própria. Para pesquisar documentos ou consultar sistemas, o produto precisa acrescentar recuperação ou ferramentas. Confundir atenção interna com acesso externo faz uma resposta parecer atualizada mesmo quando ela não recebeu uma fonte vigente.
As outras peças que sustentam as camadas
Além da atenção, uma camada inclui redes feed-forward que transformam cada posição, conexões residuais que preservam caminhos de informação e normalização para apoiar a estabilidade do treinamento. As variantes mudam a ordem, as funções de ativação, a posição e outros detalhes. Uma explicação que atribui tudo à atenção deixa de fora parte relevante da arquitetura.
Durante o treinamento, a função de perda mede diferenças em relação ao objetivo e a otimização ajusta os parâmetros por gradientes. Em um objetivo comum de modelagem autoregressiva, o modelo aprende a prever o próximo token a partir dos anteriores. Depois podem ocorrer etapas adicionais de ajuste e alinhamento. Isso produz padrões úteis, mas o objetivo estatístico não garante verdade, atualização nem autorização de cada resposta.
Por que a saída pode ser convincente e errada
Uma sequência plausível pode conter um fato inexistente. O modelo pode combinar padrões que aparecem juntos, extrapolar uma regra ou responder sem evidência suficiente. Acrescentar RAG, ferramentas e avaliação pode reduzir certos erros; continua sendo necessário testar fidelidade às fontes e reconhecer ausência de informação.
O que essa história muda numa decisão de aplicação
Se sua pergunta depende de uma política atual, a capacidade linguística precisa ser acompanhada de uma fonte vigente. Se a tarefa é decidir entre três categorias, compare um modelo especializado com geração livre. Se o problema é atualização de conhecimento entre sessões, planeje memória externa. Cada evolução histórica adiciona mecanismos; nenhuma elimina a necessidade de um contrato da tarefa.
Um experimento simples usa o mesmo conjunto de perguntas em três condições: sem documentos, com documento correto e com documento desatualizado. Avalie quais respostas citam a evidência e preservam condições. O objetivo é observar o comportamento da aplicação, não provar uma capacidade geral com uma única demonstração.
Roteiro de leitura
Comece pela representação em tokens e vetores, avance para atenção e treinamento, depois estude recuperação externa. Essa ordem explica por que a LLM consegue redigir e por que ainda precisa de busca e governança para trabalhar com conhecimento de uma organização.
