O que você precisa saber
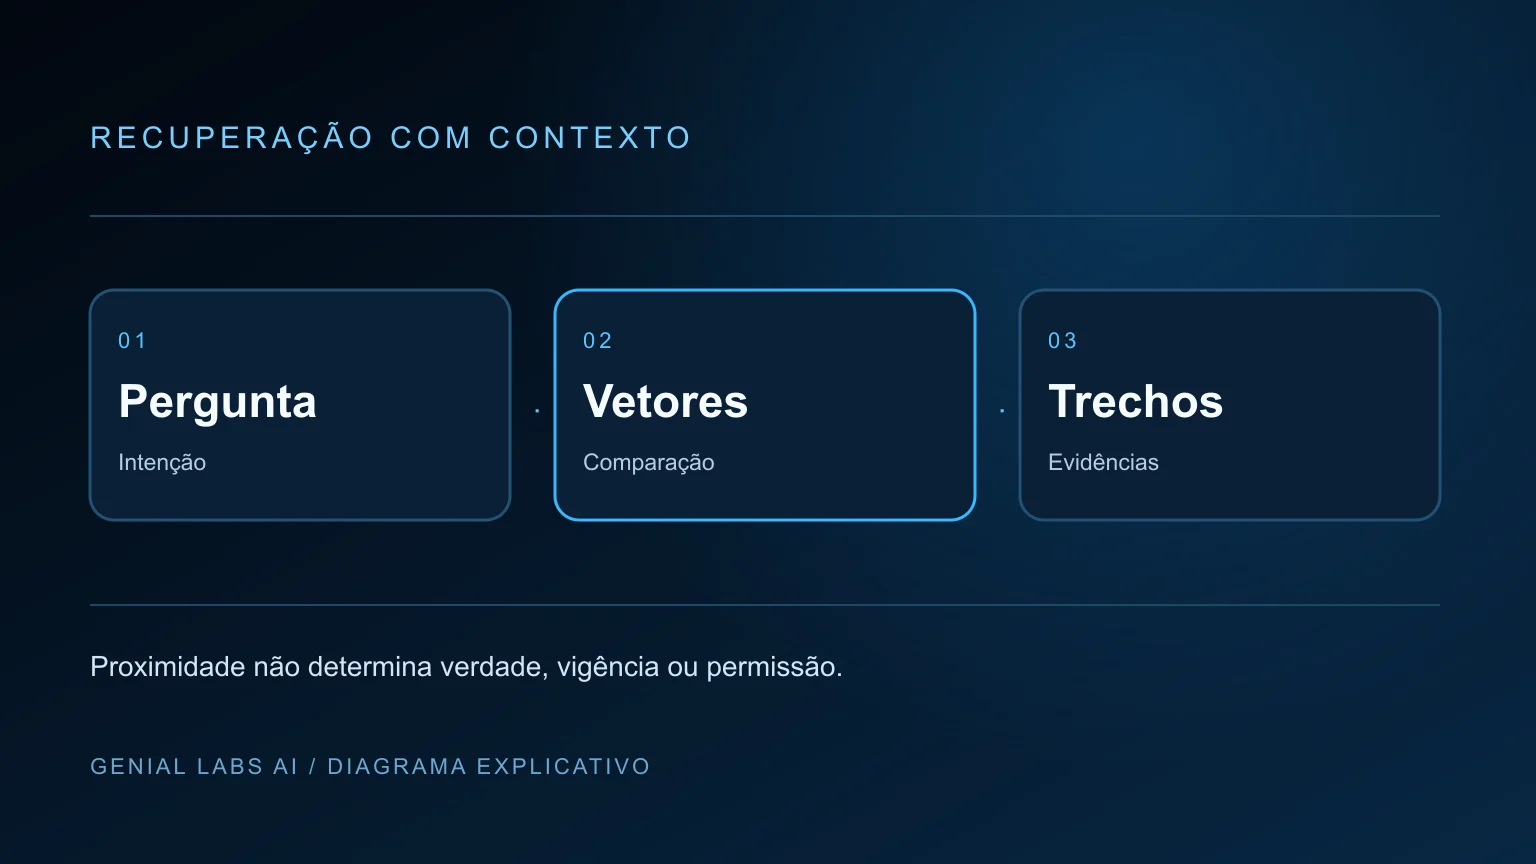
Um vetor é uma sequência de números. Um embedding é uma representação numérica aprendida para um objeto, como texto ou imagem. Na busca semântica, pergunta e documentos são representados em um espaço compatível e comparados. Proximidade ajuda a recuperar candidatos; não prova que o conteúdo é verdadeiro, vigente ou autorizado.
Vetor é a forma; embedding é a representação aprendida
O vetor [0,2; −0,7; 0,4] tem três componentes. Em sistemas reais, um embedding pode ter centenas ou milhares de dimensões. Esses números resultam de um modelo treinado; em geral, cada dimensão isolada não corresponde a uma palavra ou significado legível. A informação está distribuída entre componentes e suas relações.
Embeddings podem representar tokens dentro de um modelo ou textos completos para recuperação. Esses dois usos não são intercambiáveis por definição. Um modelo de embeddings para busca transforma pergunta e trecho em representações adequadas à comparação; um embedding interno de token participa do cálculo da linguagem dentro de outra arquitetura.
Dimensão igual não significa espaço compatível
Dois modelos podem produzir vetores com o mesmo comprimento e significados geométricos diferentes. Misturar documentos de um modelo com perguntas de outro pode prejudicar a recuperação. Registre modelo, versão, preparação do texto e dimensão. Ao trocar o espaço, planeje a reindexação e teste o índice novo antes da substituição.
Como uma pergunta encontra um trecho
A preparação começa no documento: extrair o texto, preservar tabelas e condições, dividir em trechos interpretáveis e associar metadados. Depois, o modelo gera embeddings para esses trechos. O índice armazena vetores, identificadores e campos necessários à seleção. A pergunta passa por preparação compatível e é comparada aos candidatos permitidos.
A comparação pode usar similaridade do cosseno, produto escalar ou distância, conforme o modelo e o índice. O cosseno divide o produto escalar pelo produto das normas dos vetores. Ele mede orientação relativa; não é uma porcentagem universal de verdade. Normalização e métrica precisam seguir a recomendação do modelo, e o limiar deve ser avaliado com exemplos da tarefa.
O problema do trecho certo com condição errada
Num caso hipotético, o texto recuperado informa que visitas ocorrem às 15h. A frase anterior limita essa regra à unidade Centro e ao sábado. Se o recorte perdeu essa condição, a busca entrega uma evidência incompleta. O teste não deve premiar só a presença da palavra 'visita'; deve exigir a regra inteira, com a condição de aplicação.
Para continuar este critério: RAG na empresa: como dar contexto à IA sem perder o controle da informação →
Busca híbrida e reranking resolvem problemas diferentes
Busca lexical ajuda a encontrar nomes, códigos e expressões exatas. Busca vetorial aproxima variações de significado. Um fluxo híbrido combina candidatos dos dois caminhos, aplica critérios de fusão e pode reordená-los com um reranker. O reranker examina pergunta e documento juntos para estimar relevância, geralmente com custo adicional.
Nenhuma dessas etapas deve criar autorização. Filtros de empresa, unidade, público e vigência precisam restringir o universo consultável antes de entregar conteúdo ao modelo. Dependendo do mecanismo, filtros também devem participar da recuperação para evitar que a seleção aproximada perca candidatos permitidos ou revele conteúdos proibidos em logs.
Use outra fonte quando a pergunta pede precisão transacional
Uma pergunta sobre o saldo atual de uma fatura pede consulta ao sistema oficial, com identidade e permissão. Um embedding pode ajudar a entender a intenção, mas um trecho de manual não informa o estado atual da conta. RAG de documentos, consultas estruturadas e regras de negócio devem ter papéis separados.
| Pergunta | Caminho | Condição de acerto |
|---|---|---|
| Como funciona a visita? | Busca semântica/híbrida | Política vigente e completa |
| Onde está o contrato ABC-203? | Identificador e busca exata | Objeto e autorização corretos |
| Qual meu saldo agora? | Consulta ao sistema oficial | Identidade, instante e estado |
| Quais regras se conectam? | Relações e eventual grafo | Arestas sustentadas por fontes |
Avalie recuperação antes de culpar a geração
Monte perguntas com documentos esperados e condições de aceitação. Recall@k observa se evidências relevantes entram nos primeiros k resultados; métricas de ordenação avaliam sua posição. O conjunto precisa incluir paráfrases, siglas, números, negativas e casos sem resposta. Uma média agregada pode esconder falhas graves em uma unidade ou tipo de documento.
Depois avalie a resposta separadamente. Se a evidência correta não foi recuperada, mudar o prompt do gerador talvez não resolva. Se apareceu completa e a resposta a contrariou, o problema é de interpretação, composição ou instrução. Registre pergunta, versão do índice, filtros, candidatos e resposta para localizar a falha sem expor conteúdo privado desnecessário.
Um experimento reproduzível
Escolha dez perguntas que usam palavras diferentes das fontes e dez que dependem de identificadores exatos. Compare recuperação lexical, vetorial e híbrida sobre a mesma coleção. Acrescente documentos obsoletos e de outra unidade. O número vinte é um exercício inicial, não prova estatística de prontidão.
- Defina a evidência esperada antes da execução.
- Registre os candidatos de cada mecanismo.
- Confira completude, vigência e permissão.
- Conte casos sem evidência suficiente.
- Corrija preparação ou busca e repita os casos afetados.
Perguntas frequentes e limites
É possível reconstruir o documento inteiro a partir do vetor?
Um embedding não é um arquivo compactado reversível de modo geral. Isso não o torna automaticamente anônimo ou inofensivo: representações e serviços de recuperação podem expor informações sensíveis. Proteja vetores, metadados, texto original, respostas e logs como partes do mesmo sistema.
Banco vetorial substitui o banco da empresa?
Não. O índice facilita recuperação. Transações, identidade, permissões, histórico de mudanças e registros oficiais continuam precisando de contratos próprios. Um banco relacional pode inclusive armazenar vetores junto a metadados, dependendo da solução escolhida.
