O que você precisa saber
IA e ML podem ajudar a extrair, padronizar, classificar e identificar problemas nos dados. Melhorar a base exige preservar origem, separar inferência de fato, testar qualidade e devolver correções à fonte oficial. Preencher lacunas com respostas plausíveis pode aumentar a completude e reduzir a confiabilidade ao mesmo tempo.
Defina qualidade pela tarefa, não pela aparência da planilha
Qualidade reúne dimensões como exatidão, completude, consistência, atualidade e adequação ao uso. Uma data de visita pode estar no formato correto e pertencer à unidade errada. Uma resposta preenchida pode ser apenas uma estimativa. Comece pela decisão que o dado vai sustentar e pela consequência de um erro.
Monte um contrato de campo: significado, formato, fonte, responsável, momento de atualização, valor ausente permitido e regra de validação. 'Status do contato' não basta; você precisa definir quais acontecimentos mudam o status. Um modelo pode interpretar uma mensagem, mas a confirmação de uma matrícula deve vir do evento oficial correspondente.
Fato, extração, normalização e inferência
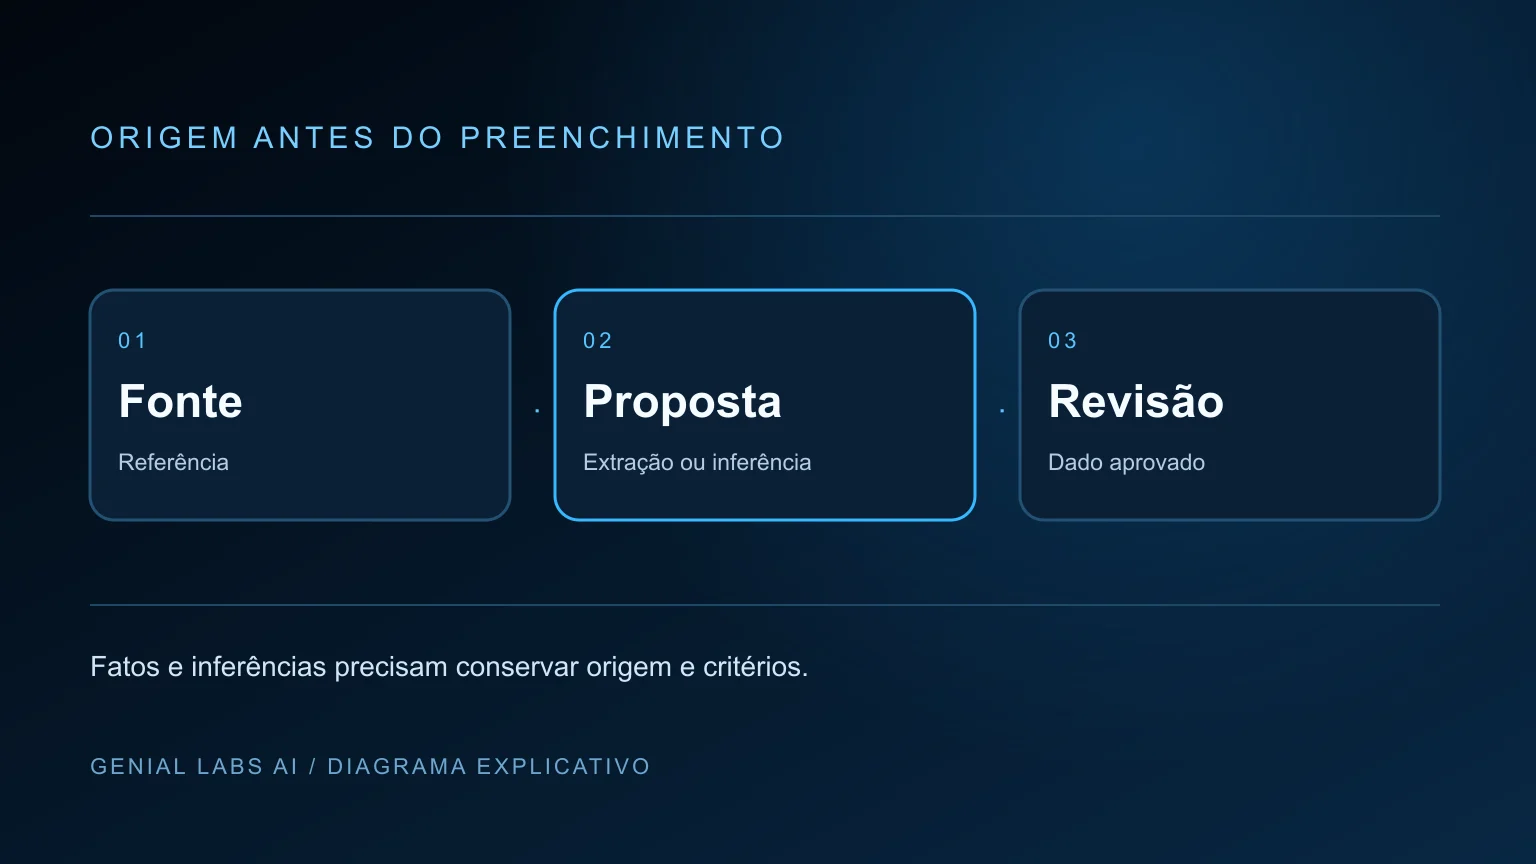
Fato é sustentado por uma fonte adequada. Extração copia ou identifica uma informação existente. Normalização transforma sua representação segundo uma regra, como uma data em formato padrão. Inferência propõe algo não declarado diretamente. Registre essas classes separadamente, junto à origem e à versão do processo. Uma inferência não ganha autoridade só porque foi colocada numa coluna.
Onde a IA ajuda e onde precisa se abster
Uma IA pode localizar campos em texto, sugerir categorias, destacar inconsistências e agrupar possíveis duplicidades. Regras determinísticas continuam úteis para validar formatos e restrições exatas. Uma consulta ao banco oficial resolve identidades e estados que dependem de registros. A combinação deve privilegiar o mecanismo mais verificável para cada campo.
Num exercício hipotético, uma mensagem diz 'prefiro à tarde'. A extração pode registrar preferência de turno. Ela não deve inventar uma visita às 15h de sábado. Se o nome tem uma grafia parecida com outro cadastro, a IA pode sinalizar um candidato; não deve fundir registros automaticamente sem critério suficiente de identidade e autorização.
Dados sintéticos têm um papel limitado
Exemplos sintéticos ajudam em testes de formato, cenários raros e desenvolvimento sem dados pessoais reais. Eles não comprovam desempenho no público real. Se forem usados em treinamento, registre a origem e avalie se reproduzem padrões artificiais. Nunca apresente dados gerados como resultados de clientes ou desfechos observados.
Para continuar este critério: Machine learning: o que é, como aprende e quando usar →
Crie uma referência revisada e um fluxo de correção
Ground truth é a referência usada para avaliar a tarefa. Ela também pode conter erros. Defina instruções de rotulagem, tratamento de ambiguidades e revisão de divergências. Uma categoria como 'interessado' deve ter exemplos positivos, negativos e inconclusivos; duas pessoas precisam conseguir aplicar a mesma definição.
Guarde o dado original de forma autorizada, a proposta do modelo, a revisão e o estado aprovado. Uma correção deve chegar ao dono da fonte, não ficar perdida numa planilha paralela. Evite sobrescrever silenciosamente fatos anteriores. Quando a tarefa depende de vigência, mantenha o que valia em cada período e a razão da mudança.
Exercício: lote pequeno com revisão
Selecione um lote representativo e autorizado. Marque campos que podem ser normalizados por regra, campos que exigem extração e campos que dependem de consulta. Revise manualmente uma amostra e todos os casos com conflito. O tamanho inicial deve refletir a diversidade, não servir como prova universal de qualidade.
- Escreva o contrato dos campos.
- Prepare exemplos e referência revisada.
- Rode o processamento sem sobrescrever a fonte.
- Compare propostas e registre tipos de erro.
- Aprove apenas as mudanças sustentadas.
- Reteste após alterar modelo, instrução ou fonte.
Evite vazamento entre futuro, treinamento e teste
Data leakage ocorre quando a avaliação usa informação que não estaria disponível na decisão real ou quando exemplos relacionados atravessam divisões de forma inadequada. Prever matrícula com uma variável preenchida depois da matrícula pode gerar uma métrica excelente e um modelo inútil. O instante da previsão precisa ser parte do contrato.
Dividir linhas aleatoriamente pode colocar o mesmo cliente no treino e no teste. Para certos problemas, use grupos por pessoa, instituição ou documento; para previsão temporal, respeite a ordem do tempo. Transformações que aprendem estatísticas devem ser ajustadas no treino e aplicadas às outras partições. O teste reservado não deve ser reutilizado indefinidamente para escolher parâmetros.
Observe a distribuição de cada recorte
Uma base dominada por uma unidade pode representar mal outra. Compare períodos, canais, idiomas e tipos de solicitação. Falhas em classes raras ou situações críticas podem desaparecer na média. Explique tamanho de amostra e limites; não transforme cinco casos sem erro em uma taxa de sucesso definitiva.
Métricas de qualidade que orientam a operação
Para extração, avalie acerto do campo e dos vínculos necessários, como pessoa e unidade. Para classificação, examine precisão, recall e matriz de confusão. Para deduplicação, conte fusões indevidas e duplicidades que escaparam. Para dados atualizados, meça atraso entre a mudança oficial e seu reflexo nos sistemas. A métrica precisa representar a falha que a equipe vai enfrentar.
Inclua cobertura e abstenção: quanto a automação resolve com qualidade e quanto devolve para revisão? Reduzir erros retirando quase todos os casos do processamento não demonstra ganho de capacidade. Compare qualidade, tempo de revisão, atraso e custo total com a linha de base. Um campo mais preenchido só é melhor se for confiável para seu uso.
Aceite antes de automatizar escrita
Defina limites por campo e consequência. Dados de baixo impacto podem receber amostragem; fusão de identidade ou mudança de situação exige controle mais forte. A aplicação deve validar esquema, permissão e integridade mesmo depois da classificação. Quando houver incerteza, mantenha o valor ausente ou encaminhe para revisão.
Mantenha qualidade depois do primeiro lote
Monitore mudanças de distribuição, novas categorias, rótulos inconsistentes e atraso de revisão. Registre versão do modelo, da preparação e da referência. Um feedback humano deve indicar o desfecho verificado, não apenas se a resposta agradou. Assim você consegue descobrir quando o modelo mudou, quando a fonte mudou e quando a própria definição da tarefa precisa mudar.
Uma rotina útil começa pelos erros recorrentes: qual origem gera mais divergência, qual campo exige mais correção e qual alteração de processo eliminaria o problema? A melhor melhoria pode ser um formulário mais claro ou uma regra de integração, em vez de um modelo maior.
