O que você precisa saber
Machine learning é o desenvolvimento de modelos que aprendem padrões a partir de dados para realizar uma tarefa. O treinamento ajusta parâmetros; a inferência aplica o modelo a novas entradas. O objetivo é generalizar para casos relevantes, não apenas acertar os exemplos usados no aprendizado.
Aprender uma relação não é escrever todas as regras
Uma regra explícita pode dizer: se a matrícula está confirmada, mova o registro para uma etapa. Um modelo de ML pode estimar a probabilidade de um contato comparecer a uma visita usando exemplos históricos. No primeiro caso, a equipe define a condição. No segundo, a relação é ajustada por treinamento. Os dois mecanismos podem trabalhar juntos.
Isso não significa que o modelo descobre causas automaticamente. Uma associação entre canal e conversão pode refletir público, orçamento ou atendimento, e não um efeito causal isolado do canal. Para decidir investimentos, você precisa distinguir previsão, associação e causalidade. O modelo também não substitui a regra que determina quem tem permissão para alterar uma matrícula.
A função de perda orienta o aprendizado
O treinamento calcula uma medida de erro em relação a um objetivo e ajusta os parâmetros para reduzi-la. A escolha dessa função e dos exemplos define o que o modelo é incentivado a fazer. Um objetivo mal formulado pode produzir um sistema eficiente em otimizar o número errado, como prever cliques quando a empresa precisa de contatos qualificados.
Quatro modalidades de aprendizado
No aprendizado supervisionado, os exemplos incluem uma saída desejada. Classificação prevê uma categoria, como tipo de solicitação; regressão prevê um valor, como demanda estimada. Rótulos precisam ser confiáveis e disponíveis segundo uma definição clara. Se 'qualificado' significa coisas diferentes para duas equipes, o alvo do treinamento já nasce inconsistente.
No não supervisionado, o sistema procura estrutura sem um rótulo de resposta por exemplo: agrupamentos e padrões são usos comuns. No autossupervisionado, o objetivo é construído a partir dos próprios dados, como prever partes de uma sequência. No aprendizado por reforço, um agente aprende com interações e sinais de recompensa. Cada modalidade tem desafios próprios; reforço não é simplesmente 'o usuário gostou da mensagem'.
Agrupar não é descobrir uma categoria verdadeira
Um agrupamento aproxima exemplos segundo as variáveis e a métrica escolhidas. Ele pode revelar uma hipótese de segmentação, mas as classes encontradas não recebem significado comercial automaticamente. A equipe deve interpretar, testar estabilidade e verificar utilidade antes de transformá-las numa política de atendimento.
Para continuar este critério: Como melhorar dados com IA e machine learning →
O ciclo completo: da tarefa ao monitoramento
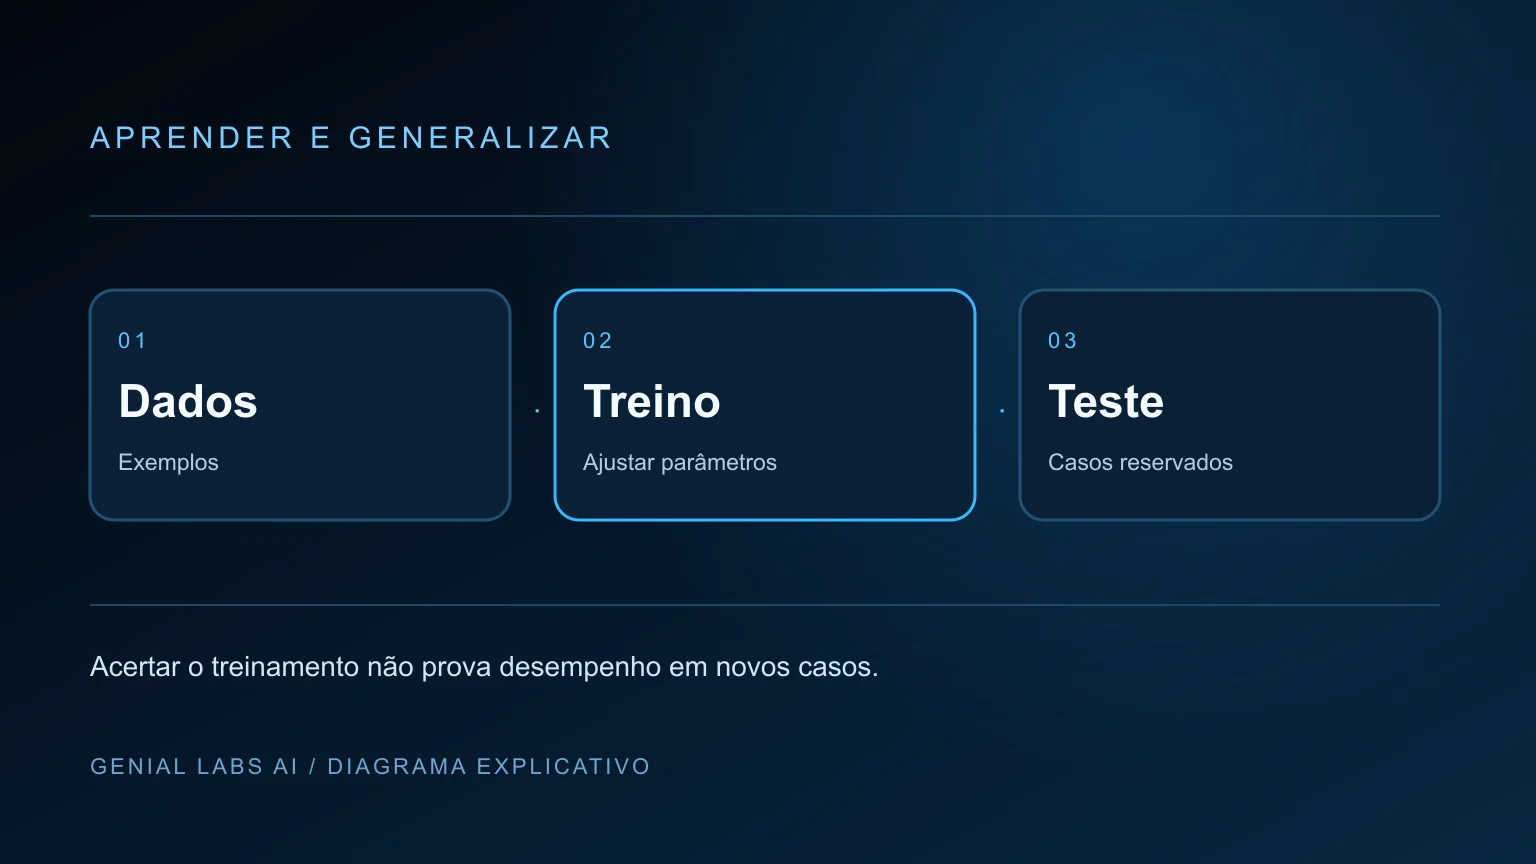
Defina primeiro a decisão apoiada pelo modelo e o momento em que ela ocorre. Depois selecione variáveis que existem nesse instante, prepare dados, treine alternativas e compare com uma linha de base. Separar treino, validação e teste evita avaliar só o material usado para ajustar o sistema. Dados temporais e clientes recorrentes exigem cuidado na divisão.
Depois da escolha, a aplicação precisa executar inferências de modo consistente: mesma preparação, versão identificada, tratamento de ausências e possibilidade de abstenção. Monitoramento acompanha entradas e resultados quando o desfecho fica disponível. Um modelo bom no teste pode degradar por mudança de público, oferta, canal ou prática operacional.
Uma linha de base que realmente desafia o modelo
Compare com uma regra simples ou com o procedimento atual usando os mesmos casos e o mesmo custo de erro. Se a alternativa barata já atende à necessidade, um modelo complexo pode não compensar. A linha de base não deve ser construída para perder; ela representa a opção prática que a empresa poderia adotar.
| Tarefa | Família possível | Teste importante |
|---|---|---|
| Tipo de mensagem | Classificação | Erros por categoria e ambiguidade |
| Demanda numérica | Regressão | Erro em períodos futuros |
| Segmentação exploratória | Agrupamento | Estabilidade e interpretação |
| Representação de texto | Autossupervisão | Qualidade na tarefa posterior |
| Escolher ações em ambiente | Reforço | Recompensa, limites e exploração |
Exemplo hipotético: priorizar contatos sem inventar certeza
Imagine 1.000 contatos com desfecho já observado. O objetivo é escolher quem receberá retorno primeiro, sem negar atendimento aos demais. Um classificador marca 100 como prováveis comparecimentos; 70 comparecem. Nesse recorte hipotético, a precisão é 70/100, ou 70%. Se havia 140 comparecimentos no total, o recall é 70/140, ou 50%. O modelo encontrou metade dos positivos, mesmo com um grupo selecionado razoavelmente preciso.
A decisão depende do custo dos erros e da capacidade da equipe. Aumentar o limiar pode reduzir contatos improdutivos e também deixar mais interessados fora da prioridade. Uma taxa de acerto geral alta pode coexistir com recall ruim quando poucos casos são positivos. Verifique ainda se diferentes unidades e públicos recebem qualidade semelhante.
Pontuação não é uma probabilidade confiável por natureza
Um score só pode ser interpretado como probabilidade útil após avaliação de calibração e definição do evento. Entre casos com previsão próxima de 70%, o resultado ocorre em proporção semelhante? Com que tamanho de amostra e em qual período? Mesmo bem calibrada, uma probabilidade de grupo não determina o destino de uma pessoa.
Quando usar ML, quando preferir regra e como começar
ML tende a ser útil quando existem variações numerosas, exemplos relevantes, repetição suficiente e um objetivo mensurável. Uma regra costuma ser melhor para condições exatas, regras aprovadas e invariantes de segurança. Uma LLM pode ajudar a extrair campos ou resumir texto, mas sua saída deve ser avaliada antes de virar variável de outro modelo.
Para começar, selecione uma única decisão reversível e registre o procedimento atual. Reserve um período futuro para avaliação, identifique quais dados realmente existem antes do desfecho e calcule o custo dos falsos positivos e negativos. Rode o modelo inicialmente como sugestão acompanhada. Ampliar autonomia exige evidência na operação, não apenas uma métrica de laboratório.
Sinais para interromper o piloto
Pare ou reduza o escopo se a fonte dos rótulos estiver em disputa, se o conjunto de teste tiver vazamento, se o resultado piorar para grupos relevantes ou se ninguém conseguir revisar um caso. Interromper uma hipótese inadequada é um resultado útil do experimento.
