O que você precisa saber
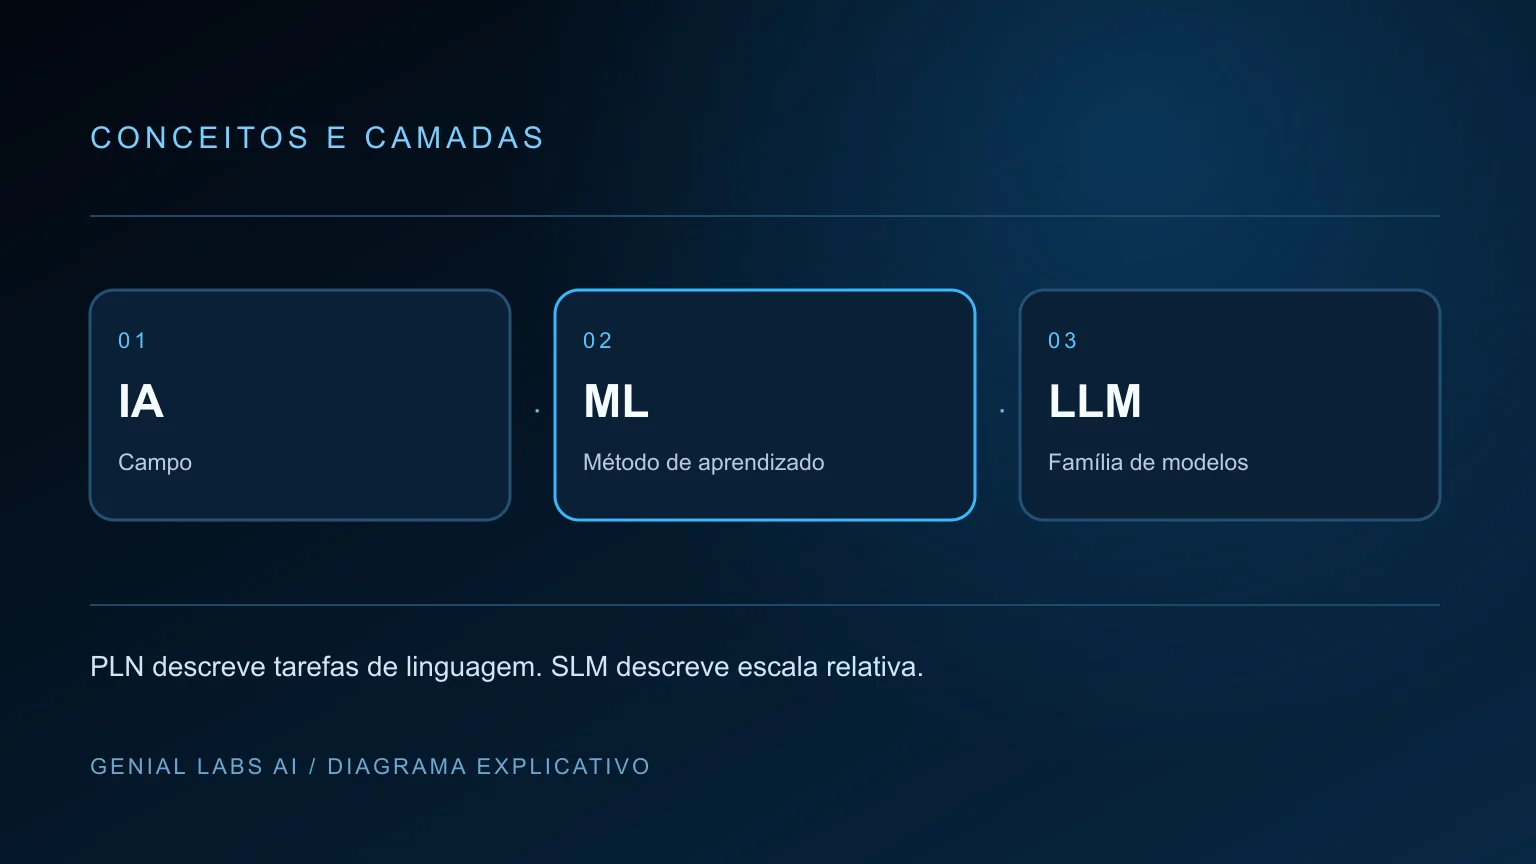
IA é o campo mais amplo. Machine learning aprende padrões a partir de dados; deep learning usa redes neurais com múltiplas camadas. PLN estuda o processamento da linguagem humana. LLMs e SLMs são modelos de linguagem de diferentes escalas, frequentemente construídos com deep learning. Esses termos descrevem camadas e disciplinas que se cruzam, não cinco produtos concorrentes.
- Um modelo pode reconhecer linguagem sem gerar texto.
- Mais parâmetros não garantem melhor resultado em uma tarefa específica.
- Contexto, memória externa e aprendizado dos parâmetros são mecanismos distintos.
IA é o campo; machine learning é uma família de métodos
Inteligência artificial reúne métodos para construir sistemas que realizam tarefas associadas a capacidades como reconhecer padrões, planejar, interpretar linguagem e escolher ações. Parte desse campo usa regras explícitas e busca. Outra parte aprende relações estatísticas a partir de exemplos. Por isso, chamar um sistema de IA ainda diz pouco sobre como ele funciona.
Machine learning, ou aprendizado de máquina, ajusta um modelo para realizar uma tarefa usando dados. Em vez de escrever uma condição para cada variação de mensagem, você fornece exemplos e um objetivo de treinamento. O sistema aprende parâmetros que relacionam entradas a saídas. Uma regra de desconto escrita no código pode fazer parte de um produto com IA, mas essa regra isolada não está aprendendo.
Deep learning não significa compreensão garantida
Deep learning é uma família de machine learning baseada em redes neurais com múltiplas camadas. Cada camada transforma representações recebidas da anterior. O treinamento ajusta pesos para reduzir uma função de erro. Redes profundas são usadas em linguagem, imagens, áudio e outros dados; não são sinônimo de chatbot.
Um erro pequeno no conjunto de treinamento não prova que o modelo se comporta bem no mundo real. Ele pode memorizar exemplos, explorar uma associação indevida ou falhar quando os dados mudam. A qualidade exige avaliação fora do treinamento e critérios relacionados à tarefa.
PLN descreve problemas de linguagem
Processamento de linguagem natural, também chamado NLP em inglês, trabalha com texto e fala. Classificar uma solicitação, extrair entidades, traduzir, pesquisar documentos e gerar respostas são problemas de PLN. Há soluções com regras, métodos estatísticos tradicionais e redes neurais. Um LLM é uma maneira importante de resolver tarefas de linguagem, mas não esgota a disciplina.
Num exemplo hipotético, detectar se uma mensagem pede cancelamento é uma tarefa de classificação. Extrair a data de uma reunião é outra tarefa. Redigir a confirmação é geração. Um único fluxo pode combinar três modelos ou usar regras em uma parte e um LLM em outra. A seleção deve seguir a necessidade de cada etapa.
Identifique o tipo de saída
Se o resultado é uma categoria finita, compare um classificador com a alternativa generativa. Se é um número previsto, considere regressão. Se precisa de linguagem flexível, contexto amplo e redação, um modelo generativo pode ser adequado. Em todos os casos, permissões de negócio devem permanecer na aplicação.
Para continuar este critério: Machine learning: o que é, como aprende e quando usar →
O que torna um modelo de linguagem grande ou pequeno?
Um modelo de linguagem aprende regularidades de sequências e calcula distribuições de probabilidade relacionadas à linguagem. LLM significa large language model; SLM significa small language model. Não existe um corte universal de parâmetros que transforme todo modelo pequeno em SLM e todo modelo maior em LLM. Os termos são relativos à geração de modelos, arquitetura e contexto de uso.
Parâmetros são os valores numéricos ajustados no treinamento. Eles não equivalem a documentos guardados em pastas. O número de parâmetros afeta capacidade e recursos necessários, mas arquitetura, dados, treinamento, especialização, quantização e tarefa também importam. Um modelo menor pode atender bem uma classificação específica e falhar numa análise longa; um maior também pode errar ambos os casos.
SLM não quer dizer offline
Rodar localmente depende de licença, formato dos pesos, runtime compatível, memória e desempenho do equipamento. Um serviço remoto também pode usar um modelo pequeno. E um modelo grande pode ser hospedado pela própria empresa se houver infraestrutura suficiente. Tamanho e localização são decisões diferentes.
| Necessidade | Alternativa a testar | Evidência necessária |
|---|---|---|
| Aplicar preço aprovado | Regra e consulta oficial | Valor, validade e permissão |
| Classificar intenção | Classificador ou modelo de decisão | Precisão por categoria e abstenção |
| Redigir síntese | LLM ou SLM generativo | Fidelidade às fontes e correções |
| Prever demanda | Modelo supervisionado | Erro futuro e mudança de distribuição |
Treinamento, inferência, contexto e memória
Treinamento altera os parâmetros. Inferência usa o modelo já treinado para processar uma nova entrada. Contexto é o material fornecido para uma execução: instruções, conversa, documentos ou resultados de ferramentas. Um produto pode salvar memória num banco e recuperar parte dela como contexto. Isso não significa que o modelo foi treinado novamente a cada conversa.
Fine-tuning ajusta um modelo com exemplos adicionais. RAG recupera informação externa e a fornece ao modelo. Prompting organiza instruções e entradas. As três técnicas podem coexistir, mas resolvem problemas diferentes. Para atualizar uma política que muda toda semana, uma fonte recuperável e versionada costuma ser mais administrável do que tentar gravar cada alteração nos pesos.
Um exercício para avaliar uma proposta
Descreva a entrada, a saída e a consequência de um erro. Marque quais informações mudam, quais fontes são oficiais e quem pode executar a ação. Depois peça uma comparação entre regra fixa, ML especializado e modelo generativo usando os mesmos casos. Essa comparação vale mais do que uma lista de siglas.
- Separe consultar, classificar, gerar e executar.
- Defina a saída aceitável de cada etapa.
- Inclua casos ambíguos e informações ausentes.
- Compare qualidade, latência e custo total.
- Escolha também quando o sistema deve se abster.
Dúvidas frequentes
LLM é a mesma coisa que IA?
Não. LLM é uma família de modelos dentro de um campo mais amplo. Existem aplicações de IA que não processam linguagem e métodos de linguagem que não usam LLMs.
Se um modelo parece conversar bem, ele conhece a minha empresa?
Fluência não demonstra acesso à informação da empresa. O sistema precisa receber dados autorizados por contexto, busca ou ferramentas. Conhecimento geral não substitui uma fonte vigente sobre seu preço, seu contrato ou seu cliente.
