O que você precisa saber
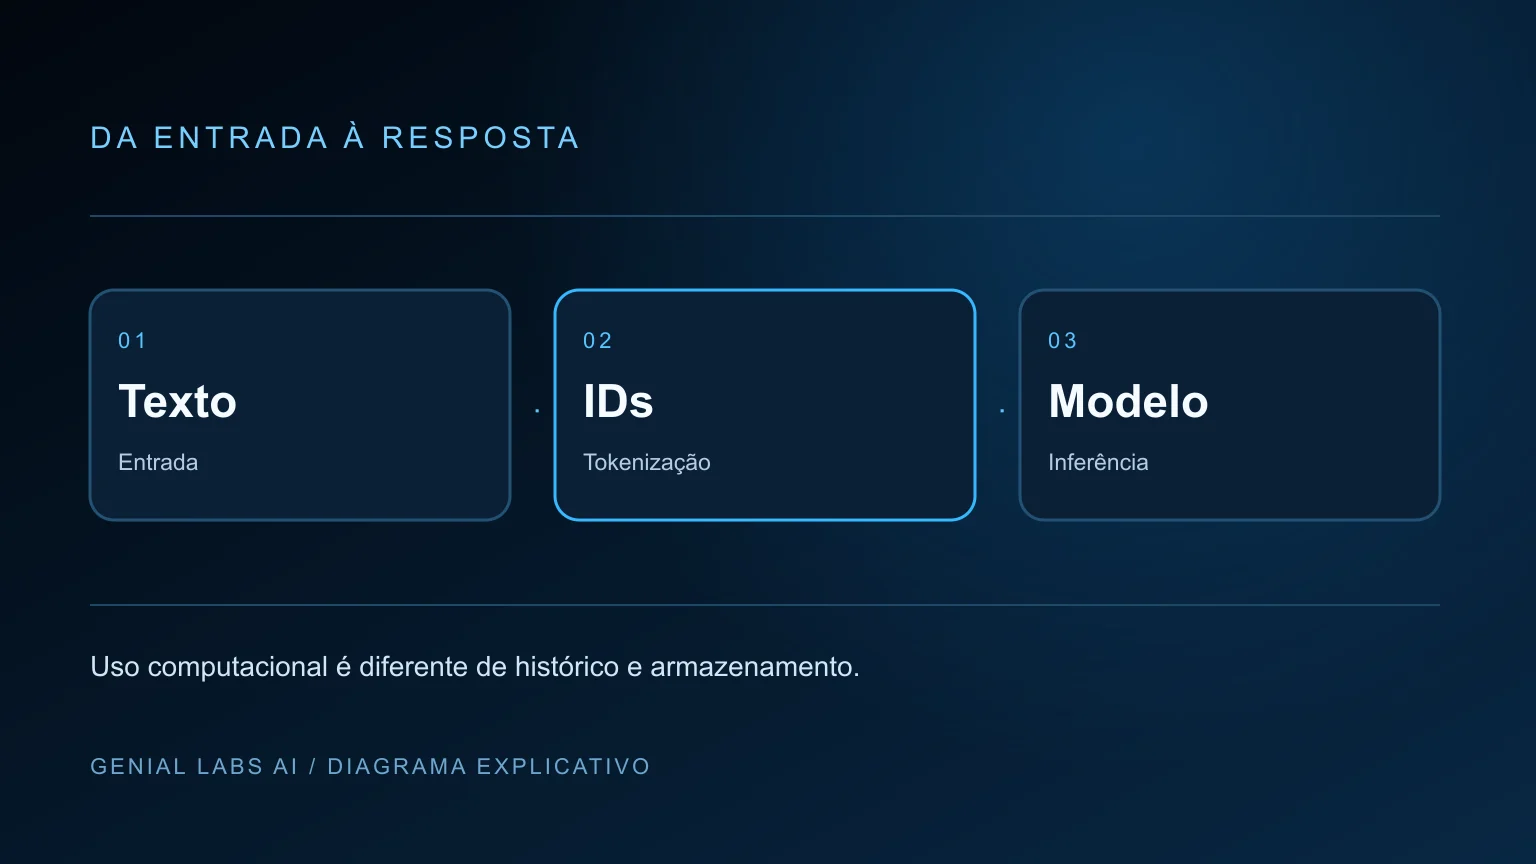
O tokenizador divide o texto em unidades e converte essas unidades em IDs numéricos. O modelo transforma os IDs em representações e calcula a saída. Tokens usados não vão para um estoque dentro da LLM: entram no processamento. Texto, logs, histórico e caches podem permanecer em sistemas diferentes conforme a implementação e a política do provedor.
Token não é necessariamente uma palavra
Um token pode corresponder a uma palavra, parte de palavra, sinal, espaço combinado a outros caracteres ou uma sequência de bytes, dependendo do tokenizador. O mesmo texto pode gerar contagens diferentes em modelos diferentes. Acentos, código, números e idiomas também alteram a segmentação. Não existe uma conversão fixa e universal entre palavras e tokens.
A frase 'agendar uma visita' não deve receber uma contagem inventada com base nas três palavras. O cálculo correto usa o tokenizador do modelo, quando disponível, ou o uso informado pela API. Além do texto visível, a requisição pode incluir instruções, histórico, definições de ferramentas e resultados recuperados. Esses elementos também ocupam contexto.
Token de linguagem e token de autenticação
Um token de autenticação é uma credencial usada para provar ou representar acesso a um sistema. Um token de linguagem é uma unidade de representação para o modelo. A chave de uma API não deve ser enviada como parte do texto para 'dar acesso' ao agente; a aplicação usa a credencial no canal técnico apropriado.
O caminho do texto dentro de uma execução
Primeiro, a aplicação prepara a entrada. O tokenizador converte o conteúdo em uma sequência de IDs. Uma camada de embedding associa IDs a vetores internos, e as camadas do modelo transformam essas representações considerando o contexto. Num modelo autoregressivo, a geração calcula uma distribuição para a próxima unidade, seleciona uma saída conforme a estratégia de decodificação e repete o processo.
Por fim, o sistema converte os tokens de saída em texto. A API pode entregar esse texto de uma vez ou em partes. O processamento ocorre na infraestrutura que hospeda o modelo: servidores do provedor ou máquinas da sua operação. É trabalho computacional, não uma transferência de moedas digitais para os parâmetros.
O que os parâmetros fazem nessa história
Os pesos aprendidos transformam as entradas e influenciam as probabilidades de saída. Na inferência comum, a execução não reescreve esses pesos com a sua mensagem. Um eventual uso posterior de dados para treinamento é outro processo, sujeito ao produto, às configurações e às condições contratadas. Deve ser verificado no provedor escolhido.
| Elemento | Função | Onde pode existir |
|---|---|---|
| Texto e histórico | Entrada e experiência do produto | Cliente, backend e armazenamento do serviço |
| IDs de tokens | Representar a sequência | Processamento e eventual cache |
| Ativações/KV cache | Apoiar cálculo da execução | Memória computacional do runtime |
| Pesos do modelo | Padrões aprendidos no treinamento | Arquivos e memória do servidor |
| Registro de consumo | Medir uso e custo | Sistemas de observabilidade e faturamento |
Para continuar este critério: Embeddings e vetores: como funciona a busca semântica →
Onde ficam os dados depois da resposta?
O modelo, o produto de chat e a API não são a mesma camada. Um chat pode salvar conversas num banco. A sua aplicação pode salvar mensagens, resumos e logs. Um runtime pode manter um cache temporário para eficiência. O provedor pode adotar retenção e controles específicos. Você precisa mapear cada camada; não dá para concluir que tudo desapareceu só porque a geração terminou.
Também não é correto dizer que cada mensagem vira automaticamente conhecimento permanente da LLM. Histórico armazenado pode ser usado em chamadas futuras sem alterar o modelo. Quando a aplicação remove um registro, é necessário considerar réplicas, backups, observabilidade e integrações conforme o contrato técnico. O local e o prazo de retenção dependem do serviço real, não do conceito de token.
Perguntas úteis para a arquitetura
Quais campos são registrados? Quem acessa os logs? Qual é o prazo de retenção? O histórico volta ao modelo inteiro ou resumido? Dados de uma empresa podem aparecer no contexto de outra? Qual configuração controla eventual uso para treinamento? Responder essas perguntas define o fluxo dos dados com mais precisão que perguntar apenas onde 'os tokens ficam'.
Janela de contexto não é memória permanente
A janela de contexto limita o material que o modelo consegue considerar numa execução, conforme suas especificações. Conversas longas podem exigir corte, resumo ou recuperação seletiva. Um limite grande não garante atenção uniforme a todos os detalhes, nem substitui uma política de seleção de fontes. A aplicação precisa preservar condições relevantes, como unidade, vigência e exceções.
Em uma conversa hipotética, a regra 'horário sujeito à confirmação da unidade' pode desaparecer numa compactação inadequada. Guardar milhares de tokens de mensagens antigas não ajuda se a condição decisiva ficou de fora. Por isso, medir cobertura das informações importantes é tão necessário quanto medir quantidade.
Exercício: audite uma única chamada
Liste separadamente instruções, conversa, documentos, ferramentas e resposta. Registre o uso retornado pelo provedor e o motivo de incluir cada trecho. Remova duplicações, recupere apenas fontes pertinentes e compare a qualidade usando casos de teste. Economizar contexto só é um ganho quando não aumenta erros.
Cobrança: token, crédito e orçamento são coisas diferentes
O crédito é um saldo ou unidade comercial definida pelo serviço. O token é uma unidade técnica que pode alimentar a cobrança. Entrada, saída, cache e outros recursos podem ter preços e regras próprios. Modelos e provedores não oferecem uma unidade econômica intercambiável: um milhão de tokens de dois modelos pode representar custo, qualidade e desempenho diferentes.
Exemplo aritmético hipotético: 2.000 tokens de entrada a US$1 por milhão custam US$0,002; 500 de saída a US$4 por milhão custam mais US$0,002. O subtotal é US$0,004, antes de outras cobranças aplicáveis. Esses valores são premissas didáticas, não preços de um fornecedor. Para precificar um serviço, some busca, ferramentas, tentativas, infraestrutura e revisão.
O que conferir antes de revender consumo
Defina modelo, unidade, limite e medição por cliente. Registre o uso confirmado do provedor e diferencie reserva de orçamento de consumo final. Um saldo na sua plataforma não é um pacote universal aceito por todas as LLMs. Ele financia um serviço com regras que você precisa explicar e sustentar.
