O que você precisa saber
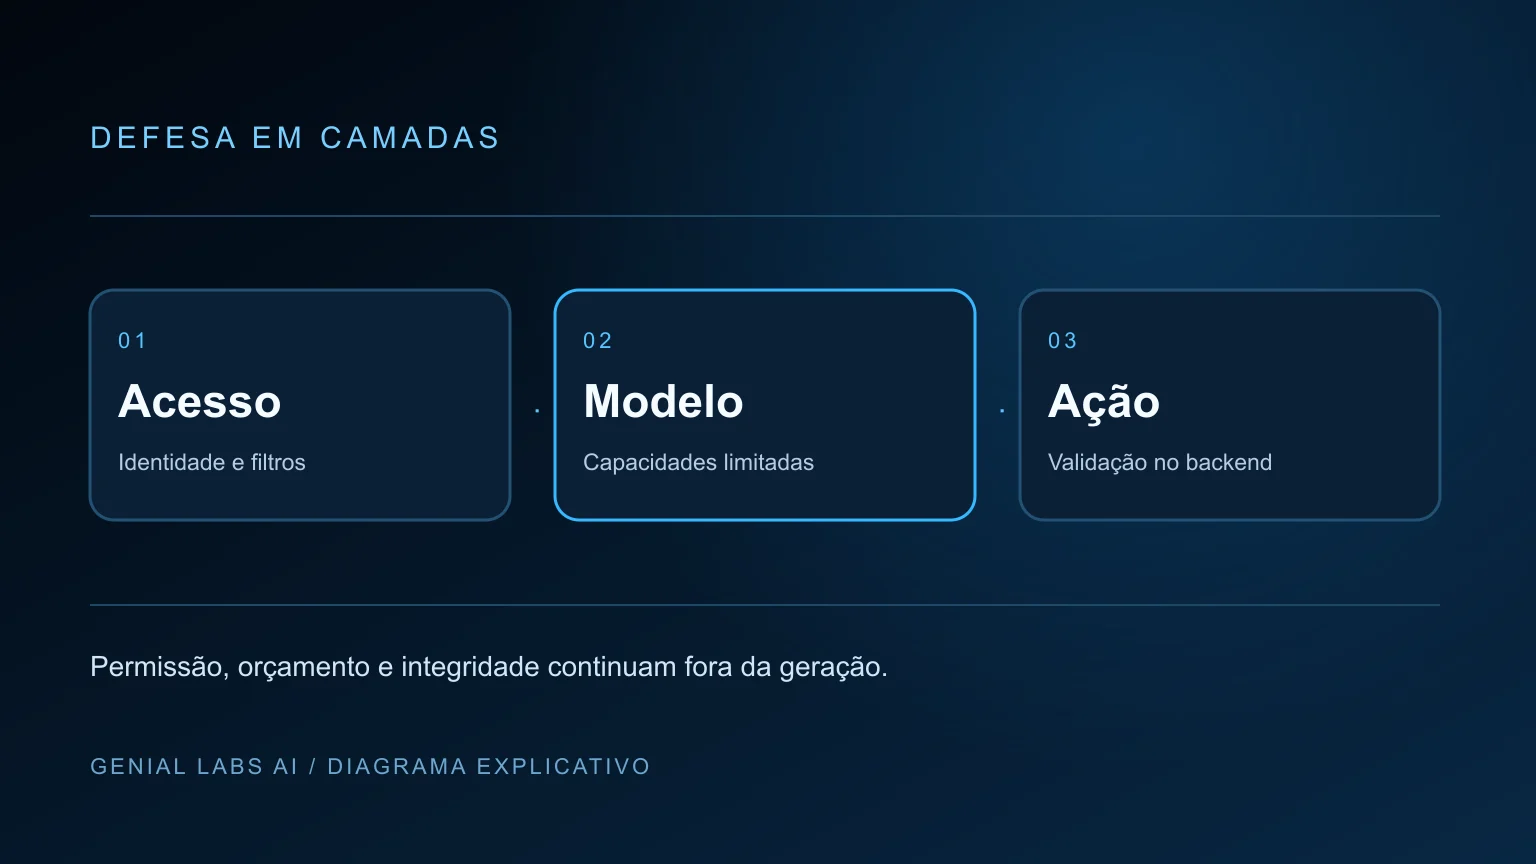
Não existe um prompt que torne uma LLM imune a ataques. Uma aplicação reduz riscos com autenticação, autorização antes da recuperação, ferramentas de menor privilégio, validação de saídas, controles de execução, proteção de segredos e avaliação contínua. O modelo participa da tarefa; o backend mantém as fronteiras de segurança.
Faça um mapa das consequências antes do filtro
Liste dados consultáveis, ações possíveis, identidades envolvidas e efeitos proibidos. Uma aplicação de leitura e um agente capaz de enviar propostas exigem controles diferentes. Identifique quem pode aprovar uma ação, o que é reversível e onde uma falha pode atingir outra pessoa ou empresa. Esse mapa orienta testes e limites.
Em um cenário hipotético de atendimento escolar, o agente pode consultar políticas públicas e preparar uma resposta. Alterar matrícula, negociar condições e enviar mensagens a terceiros são capacidades adicionais. Não conceda essas capacidades por conveniência e depois tente escondê-las num prompt. Se uma ferramenta não é necessária à tarefa, ela não precisa estar disponível.
Transforme cada risco numa regra verificável
'Não vazar dados' precisa virar condições como: nenhum documento de outra unidade é recuperado; nenhum resumo privado entra no índice público; nenhum destino é escolhido por conteúdo externo; nenhum objeto é alterado sem autorização no backend. Regras observáveis permitem detectar falhas reais.
Identidade e permissão antes de RAG e ferramentas
Determine usuário, organização e unidade a partir de autenticação confiável. A entrada textual não pode escolher um tenant. A autorização deve restringir fontes antes de elas alcançarem o modelo. Consulte apenas documentos e objetos necessários à tarefa, usando controles que também se apliquem a metadados, resumos, caches e logs.
O índice vetorial não é um mecanismo de permissão. Uma busca muito semelhante pode devolver o documento errado para a pessoa errada. Faça testes negativos entre empresas e unidades, incluindo identificadores parecidos, usuários revogados e conteúdo derivado. A resposta 'não tenho acesso' só vale se os dados proibidos nunca tiverem sido entregues ao modelo ou expostos em outra saída.
A fonte continua sendo não confiável para instruções
Mesmo um documento acessível pode conter texto de terceiros, histórico ou conteúdo adulterado. Preserve sua origem e trate suas instruções como dados de referência. Fonte aprovada para leitura não equivale a autoridade para mudar a tarefa ou executar ações.
Para continuar este critério: Prompt injection e jailbreak: diferenças e riscos reais →
Ferramentas finitas e execução com validação própria
Ofereça funções com parâmetros delimitados e tarefas específicas. Prefira uma consulta de disponibilidade a um shell geral; prefira uma operação de cadastro com esquema a SQL arbitrário. O executor valida identidade, objeto, unidade, regra de negócio e estado atual novamente antes da escrita. Uma saída bem formada pode continuar semanticamente errada ou não autorizada.
Para ações que têm efeitos, use idempotência, limites e confirmação proporcional ao impacto. Uma decisão deve carregar contexto suficiente para revisão, mas não credenciais. Releia o estado quando houver risco de a informação ter mudado entre sugestão e execução. Registre pedido, aceite do provedor e estado persistido separadamente: uma chamada aceita não comprova a conclusão do trabalho.
Quando usar sandbox
Se a tarefa realmente exige executar código ou manipular arquivos, limite ambiente, rede, diretórios, tempo e recursos. Separe dados de clientes e credenciais de produção. O isolamento deve ser técnico e verificável; chamar uma ferramenta de 'segura' não impõe esses limites.
Saída de modelo não é código nem autorização
Valide o esquema de saídas estruturadas e recuse campos desconhecidos ou valores fora do catálogo. Use consultas parametrizadas e renderização adequada ao destino. Texto gerado não deve ser interpolado como comando, HTML ativo ou SQL sem o contrato correto. Filtros de linguagem não substituem essas medidas tradicionais.
Proteja segredos no canal técnico apropriado e evite colocá-los em prompts, documentos recuperáveis ou logs. Observabilidade deve registrar a informação necessária para localizar uma falha sem virar uma segunda base de dados sensíveis. Defina acesso, retenção e redação dos registros, incluindo erros e payloads de ferramentas.
Quotas limitam abuso e falhas de planejamento
Imponha teto de chamadas, tokens, tempo, custo e concorrência por cliente e tarefa. Um agente que insiste em buscar pode consumir recursos sem progredir. Limites precisam estar no executor ou gateway e continuar funcionando quando a LLM não obedece à instrução de parar.
Avaliação defensiva que mede efeito final
Prepare ambiente de teste com ferramentas simuladas e dados sintéticos. Inclua injeção indireta, objetos de outra unidade, saída malformada, duplicação de ação, fonte contraditória, serviço indisponível e limite excedido. Observe o conteúdo entregue ao modelo, a ferramenta chamada e o estado final. A ausência de uma resposta ofensiva não prova que o acesso foi correto.
Registre versão do modelo, instrução, índice e executor. Uma troca de qualquer peça exige reteste dos casos relevantes. Testes automatizados de autorização e integridade devem acompanhar a avaliação linguística. A segurança do modelo e a segurança da aplicação se complementam; nenhuma deve servir de desculpa para ignorar a outra.
Critérios para aumentar autonomia
Defina quais falhas bloqueiam a liberação, como o sistema se abstém e quem recebe a exceção. Avalie qualidade e cobertura em conjunto. Sem saída humana acompanhada, o sistema pode acumular tarefas inconclusivas em silêncio. A ampliação deve ser gradual e reversível.
- Permissão testada antes de recuperar e antes de executar.
- Catálogo de ferramentas restrito à tarefa.
- Falha crítica impede avanço, sem fallback que amplia acesso.
- Custos e tempo limitados tecnicamente.
- Evidências de efeitos persistidos e fluxo de revisão.
- Reavaliação após mudanças de modelo, fonte ou política.
Como manter a defesa na operação
Monitore violações de contrato, consultas negadas, loops, mudanças de fonte e erros por categoria. Um alerta útil aponta tarefa, versão, fronteira e próximo responsável; não publica a informação que tentou proteger. Revogue acessos quando necessário e mantenha um caminho para interromper capacidades de escrita sem derrubar toda a leitura.
Defesa em camadas reduz risco e limita consequências. Não permite prometer que a LLM está 'blindada 100%'. O compromisso verificável é um conjunto de capacidades controladas, testes pertinentes, rastreabilidade e correção quando aparece uma falha. Esse compromisso continua depois da primeira publicação.
