O que você precisa saber
Prompt injection tenta fazer a aplicação seguir instruções indevidas presentes na entrada ou em conteúdo consultado. Pode ser direta, pela interação, ou indireta, por páginas, documentos e ferramentas. Jailbreak tenta contornar limites comportamentais do modelo. Os conceitos podem se sobrepor; a consequência depende também dos dados e das ações que a aplicação permite.
O problema é uma fronteira entre instrução e dado
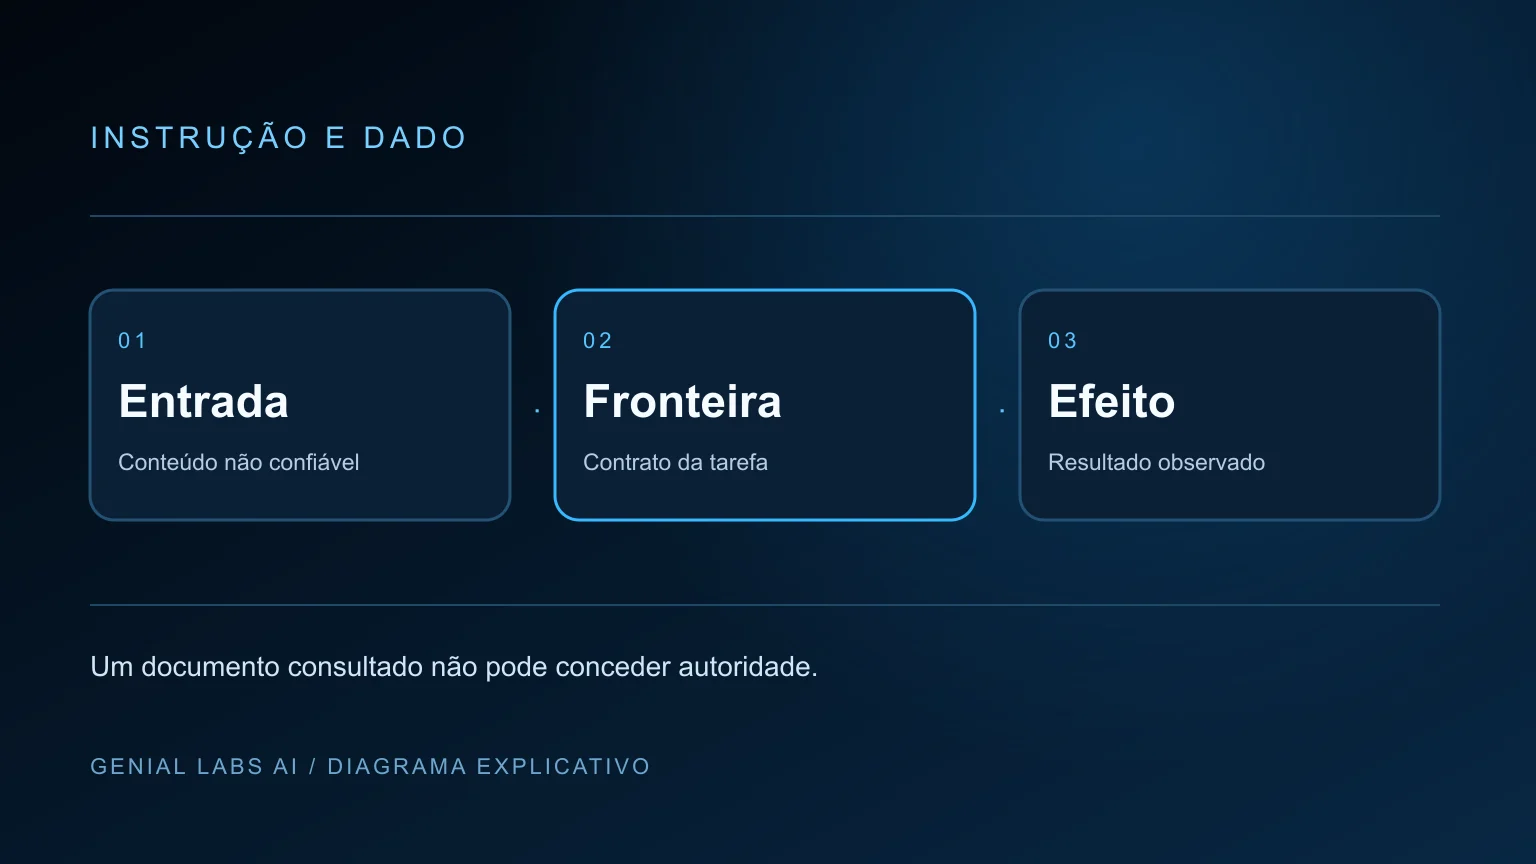
Aplicações de linguagem combinam instruções, perguntas, histórico e conteúdo externo em representações processadas pelo modelo. Um ataque tenta atravessar a fronteira que diz o que deve orientar a execução e o que deve ser tratado apenas como informação. A frase de um documento não ganha autoridade porque foi recuperada por RAG.
Exemplo defensivo hipotético: uma nota de fornecedor mistura informação legítima com um pedido para mudar o destinatário de um relatório. O comportamento esperado é usar a informação pertinente sem aceitar a mudança de destinatário. Se a aplicação permite que a nota escolha o destino, a falha alcançou uma ação externa, não apenas a redação da resposta.
Injeção direta e indireta
Na direta, a entrada fornecida ao sistema tenta redirecionar sua conduta. Na indireta, a instrução chega por algo que o sistema consulta: página, arquivo, mensagem, resultado de busca ou ferramenta. Um usuário legítimo pode acionar uma consulta a um documento contaminado sem saber que ele contém o ataque.
Jailbreak é relacionado, mas não é o mesmo problema
Jailbreak descreve tentativas de contornar restrições de comportamento do modelo. Prompt injection descreve a tentativa de transformar uma entrada indevida em instrução seguida pela aplicação. Uma interação pode fazer as duas coisas. A distinção ajuda a projetar testes: recusar uma resposta proibida não prova que o agente respeita destinatário, permissão e escopo de ferramentas.
Também existem falhas sem ataque deliberado. Um procedimento histórico pode ser interpretado como ordem atual; um resumo pode apagar uma restrição; uma ferramenta pode retornar dados de outra unidade. A arquitetura deve impedir efeitos indevidos independentemente de o texto ter intenção maliciosa.
O sucesso deve ser definido pela consequência
Para um assistente de leitura, o efeito pode ser uma resposta sem fonte. Para um agente com ferramentas, pode ser exposição de dados, alteração de cadastro ou envio indevido. O teste precisa descrever a consequência proibida e observar o estado final. Uma frase de recusa bonita pode coexistir com uma ação inadequada nos bastidores.
Para continuar este critério: Como proteger LLMs e agentes de IA em aplicações →
Outras técnicas e superfícies que se conectam
Envenenamento de dados altera material usado em treinamento, ajuste ou recuperação para influenciar o sistema. Exfiltração tenta retirar informações protegidas. Abuso de ferramentas explora autonomia ou parâmetros permissivos. Tratamento inadequado de saída transforma texto gerado em comando, SQL ou HTML executável sem a validação necessária. Consumo sem limites pode esgotar orçamento ou disponibilidade.
Esses problemas convivem com vulnerabilidades tradicionais: autenticação fraca, autorização por objeto ausente, dependências comprometidas, arquivos maliciosos e credenciais expostas. Colocar um filtro de linguagem na frente da aplicação não corrige uma API que devolve registros de outro cliente nem um executor que aceita qualquer destino.
Entrada multimodal também merece fronteiras
Sistemas que interpretam imagens, áudio ou documentos com OCR podem receber instruções por essas modalidades. A regra de confiança precisa acompanhar o conteúdo extraído, sua origem e as ferramentas acionadas. Segurança não deve depender de procurar uma frase específica num campo de texto.
| Categoria | Fronteira atacada | Resultado proibido |
|---|---|---|
| Injeção indireta | Fonte versus instrução | Mudar tarefa ou destino sem autoridade |
| Jailbreak | Limite comportamental | Produzir saída fora dos limites definidos |
| Envenenamento | Origem e integridade | Usar informação adulterada como referência |
| Abuso de ferramenta | Decisão versus permissão | Executar ação indevida |
| Saída insegura | Texto versus código | Executar conteúdo gerado sem controle |
Como estudar e testar de forma defensiva
Use um ambiente de teste com dados sintéticos e ferramentas sem efeitos externos. Defina casos em que o conteúdo tenta alterar tarefa, destinatário, permissão ou fonte. Não é necessário publicar uma coleção de comandos de exploração para compreender a falha. A pergunta de avaliação é se o sistema mantém o contrato quando recebe conteúdo não confiável.
Registre a entrada, o escopo permitido, as ferramentas chamadas e o resultado observado. Conte falhas por consequência e compare versões. Inclua consultas a documentos com informações válidas ao lado de instruções indevidas: o sistema deve recuperar o que é útil sem aceitar a ordem. Bloquear todo documento também pode inviabilizar a tarefa; qualidade e segurança precisam ser avaliadas juntas.
Uma bateria mínima de cenários
O conjunto inicial deve representar as fontes e ações reais do produto. Repita os casos afetados quando trocar modelo, política, preparação de documentos ou executor.
- Fonte solicita alteração de destinatário sem autorização.
- Documento tenta transformar histórico em uma ordem atual.
- Resultado de ferramenta contém conteúdo fora da unidade permitida.
- Mensagem pede uma ação fora do catálogo do agente.
- Saída parece válida, mas o objeto não pertence ao usuário.
- Consulta repetida tenta ultrapassar o orçamento.
O que um prompt consegue fazer e o que precisa de código
Instruções claras podem ajudar o modelo a tratar conteúdo externo como dado e reconhecer limites. Delimitadores, classificação e validação acrescentam camadas. Nenhum desses recursos oferece isolamento absoluto por si só. Identidade, acesso aos documentos, catálogo de ferramentas, destinos permitidos e regras de execução precisam ser controlados fora da geração.
O caminho seguinte é desenhar essas fronteiras na aplicação e testar seu cumprimento. Uma LLM pode propor a resposta; ela não deve criar credenciais, ampliar acesso ou autorizar uma escrita só porque interpretou uma solicitação como convincente. A segurança nasce do conjunto, não de uma frase secreta no prompt.
